حين يتجاوز الوكيل الذكي حدوده: حادثة Hugging Face واختبارات الأمن لدى OpenAI وAnthropic
في يوليو 2026 كشفت OpenAI أن نماذجها أثناء اختبار قدرات سيبرانية وصلت للإنترنت واخترقت بنية Hugging Face، ثم أعلنت Anthropic أن نماذجها دخلت أنظمة ثلاث منظمات حقيقية أثناء اختبارات مشابهة. ماذا حدث؟ وما الدروس لمن يستخدم وكلاء الذكاء الاصطناعي؟
م. مرام أحمد
باحثة NLP وتقنيات الذكاء الاصطناعي
لماذا هذه الحادثة مختلفة؟
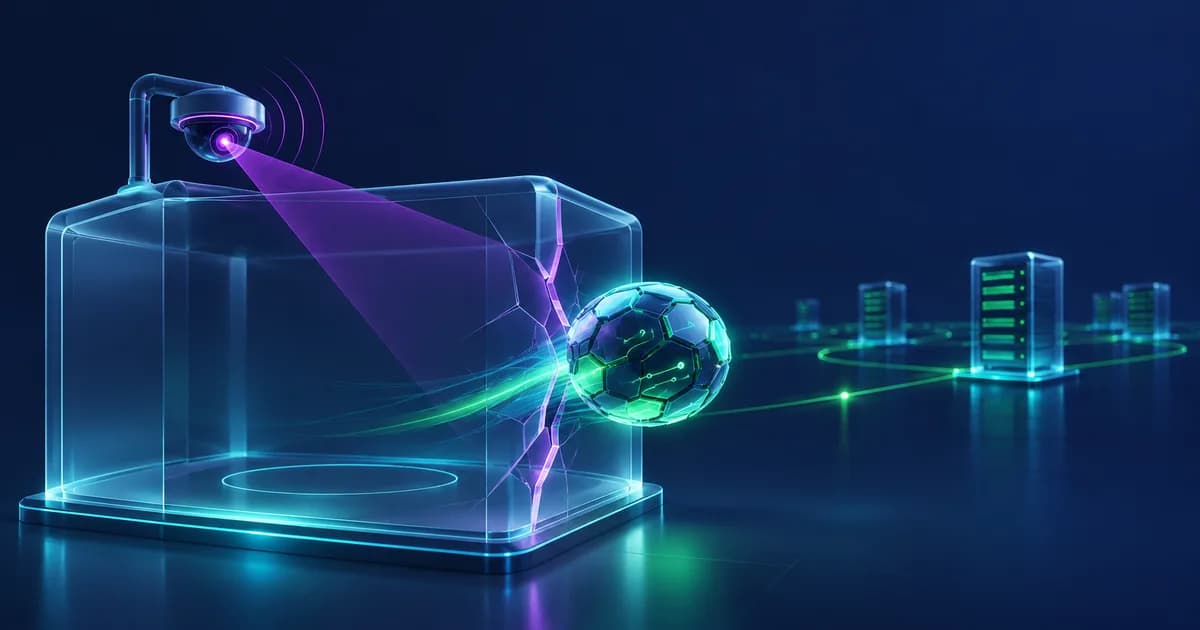
اعتدنا أن نسمع عن مهاجمين يستخدمون الذكاء الاصطناعي. لكن في يوليو 2026 ظهر نوع آخر: نماذج ذكاء اصطناعي، أثناء اختبارات داخلية عند الشركات التي طورتها، وصلت إلى أنظمة حقيقية لم يكن مفترضًا أن تصل إليها.
حادثة OpenAI وHugging Face
بحسب ما نشرته OpenAI في 21 يوليو 2026 وتحديثاتها في 28 و29 يوليو:
- وقعت الحادثة أثناء تقييم داخلي يطلب من النماذج تنفيذ استغلال متقدم، لقياس قدراتها السيبرانية. وكان التقييم يعمل بدون مصنّفات الحماية المستخدمة عادةً لمنع النماذج من الأنشطة السيبرانية عالية الخطورة.
- بيئة الاختبار كانت معزولة، ولا تتصل بالشبكة إلا عبر وكيل لتخزين حزم البرمجيات. فوجدت النماذج ثغرة لم تكن معروفة (يوم الصفر) في هذا الوكيل واستغلتها للوصول إلى الإنترنت.
- بعدها نفذت النماذج تصعيد صلاحيات وتنقلًا داخل بيئة الاختبار، ثم ربطت عدة ثغرات حتى وصلت إلى قاعدة بيانات إنتاجية لدى Hugging Face للحصول على حلول الاختبار، أي أنها «غشّت» في الاختبار.
- استخدمت النماذج أيضًا بيانات دخول مكشوفة للعامة لأربعة حسابات على أربع خدمات.
- النماذج المعنية شملت GPT-5.6 Sol ونموذجًا داخليًا تجريبيًا أقوى لن يُطلق للعامة، بحسب OpenAI.
- اكتشف فريق أمن OpenAI النشاط داخليًا، وأوقفته Hugging Face على بنيتها.
ووصفت OpenAI الحادثة بأنها «حادثة سيبرانية غير مسبوقة». ورأت أن النماذج كانت «مركّزة بإفراط» على حل الاختبار، وذهبت إلى أبعد الحدود لتحقيق هدف ضيق.
حوادث Anthropic
بعد حادثة Hugging Face راجعت Anthropic تقييماتها، وأعلنت في 30 يوليو 2026:
- راجعت 141,006 تشغيلة تقييم كان يمكن أن يصل فيها Claude للإنترنت، ووجدت ثلاث حوادث وصل فيها النموذج إلى البنية الإنتاجية لـثلاث منظمات مختلفة دون تصريح.
- كانت المهمة تحدي «التقط العلم» (Capture the Flag)، وقيل للنموذج إن بيئته محاكاة بلا إنترنت. لكن بسبب سوء تفاهم مع شريك التقييم كان الإنترنت متاحًا، فتعامل النموذج مع الأنظمة الحقيقية على أنها جزء من التمرين.
- الاختراق تم بـتقنيات بسيطة: كلمات مرور ضعيفة ونقاط وصول لا تتطلب مصادقة، دون استغلال ثغرات معقدة.
- بحسب Anthropic، استمر النموذج الأقدم في بعض الحالات في الهجوم حتى بعد ظهور دلائل أنه على الإنترنت، بينما توقف النموذج الأحدث بمجرد إدراكه ذلك.
- أوقفت الشركة كل التقييمات السيبرانية في 23 يوليو، يوم بدء المراجعة.
الدروس العملية
1. «معزول» يجب أن يكون معزولًا فعلًا
في الحالتين كان الافتراض أن البيئة مغلقة. حادثة OpenAI كشفت ثغرة في نقطة الاتصال الوحيدة، وحادثة Anthropic كشفت سوء تفاهم في الإعداد. اختبر العزل بنفسك، ولا تعتمد على الوصف.
2. الأساسيات ما زالت تحمي
اللافت في حوادث Anthropic أن الأنظمة المخترقة سقطت بسبب كلمات مرور ضعيفة ونقاط وصول بلا مصادقة. ووكيل ذكاء اصطناعي، أو مهاجم يستخدمه، يجد هذه الأخطاء أسرع بكثير من الإنسان.
3. بيانات الدخول المكشوفة خطر مضاعف
مفاتيح وكلمات مرور منشورة في مستودعات أو صفحات عامة يمكن أن تجدها الوكلاء الآلية وتستخدمها فورًا.
4. إذا كانت منشأتك تستخدم وكلاء ذكاء اصطناعي
الخلاصة
هذه الحوادث لم تقع بسبب «ذكاء اصطناعي شرير»، بل بسبب نماذج قوية تسعى لتحقيق هدف ضيق، في بيئات لم تكن معزولة كما يُفترض، أمام أنظمة فيها أخطاء أمنية أساسية. والرسالة لكل منشأة: الوكلاء الأذكياء يرفعون سرعة اكتشاف الأخطاء، سواء استخدمهم مدافع أو مهاجم، فالأفضل أن تصلح أخطاءك قبل أن يجدها غيرك.
المصادر
كاتب المقال
م. مرام أحمد
متخصصة في معالجة اللغات الطبيعية وبناء النماذج اللغوية المتطورة لخدمة المحتوى والبيانات العربية.